RPent + DeepSeek:让机械臂在仿真中学会抓取、堆叠与复用经验
给模型一句“把橙色方块放到黄色方块上”,它能否自己观察场景、规划动作、控制机械臂,并把执行经验留给下一次任务?
这次实践使用 RPent 组织 Agent 的执行流程,接入 DeepSeek 作为 planner,在 MotrixSim 的 Colorstack 场景中控制 UR5e + 2F-85,并通过 RPent memory 保存前期探索得到的操作经验。固定 memory 后,系统在 10 个随机位置布局中连续完成任务;10 次运行均通过环境判定、正常结束,并保存了完整轨迹。
成功结果之外,这组实验也暴露出三个问题:模型仍会重复推导 memory 已经给出的几何关系;成功轨迹可能产生错误的经验解释;任务完成后的总结存在明显冗余。它们说明,能完成任务只是第一步,如何让经验可靠地进入下一次决策同样关键。
从一句指令到一次完整堆叠
任务目标包括四个连续条件:抓起橙色方块,将其放到黄色方块上,完全打开夹爪,并让机械臂撤离。下面两张图来自同一次运行,使用的随机种子为 511616025。
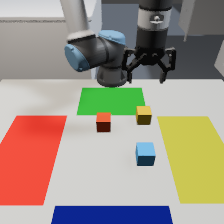
初始布局。系统需要从图像中定位橙块和黄块,再计算抓取与放置位置。
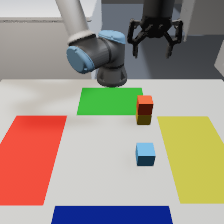
任务结束。橙块已堆叠在黄块上,夹爪打开并撤离。
完整动作由六次机械臂移动构成:接近橙块、下降抓取、抬升、移动到黄块上方、下降放置、撤离。夹爪在抓取时闭合一次,在放置时打开一次。执行过程中,Agent 还需要判断方块是否随夹爪移动,并在抬升后重新估计持物相对工具中心点(TCP)的偏移。
Colorstack 使用独立的环境判定检查任务结果:
- 两个方块的水平中心距离不超过 10 mm;
- 两个方块的中心高度差为 50 ± 5 mm;
- 夹爪完全打开;
- TCP 距离橙色方块中心至少 100 mm;
- 方块连续稳定至少 0.5 秒。
最终结果以这组环境信号为准;模型在完成操作后调用 finish 结束会话并提交执行摘要。
RPent 如何把模型、感知和机械臂连起来
DeepSeek 使用的模型标识为 openai-chat:deepseek-flash,通过 RPent 的 API planner 运行。模型接收任务、提示词、memory 和工具返回值,再选择下一步工具调用。RPent 负责执行调用、返回新的观测,并记录模型请求与动作结果;MotrixSim 负责物理仿真和机械臂运动;SAM3 根据文本提示分割图像中的目标。
主要工具构成了一条“观察—计算—动作—验证”的闭环:
| 工具 | 作用 |
|---|---|
view_env_state | 获取相机图像、TCP 位姿和夹爪状态 |
segment | 分割目标,返回可见表面在 base 坐标系中的统计信息 |
view_gripper_geometry | 计算指定姿态下 finger pad 的位置和范围 |
move_to | 将 TCP 移动到给定的绝对位置和姿态 |
set_gripper / release | 闭合或打开夹爪 |
finish | 提交执行结果并保存诊断记录 |
六条移动指令背后需要完成一系列坐标转换。图像中的目标中心、分割结果的可见表面中点、方块的几何中心和机器人 TCP 分别代表不同的量。Agent 先用视觉结果定位方块,再结合夹爪几何计算 TCP 目标。方块被夹起后,它在夹爪中的实际位置还可能变化,因此放置高度需要根据本次抓取重新估计。
Prompt 设计:把操作任务拆成不同功能
机械臂任务的 Prompt 同时描述目标,并约束坐标、感知、动作、memory 和结束条件。Colorstack 将这些规则拆成多个具名区块,再根据评测或探索模式组合对应的 memory 规则。每条指令都有清晰的功能归属,运行时信息也能与长期稳定的操作契约分开。
最终交给模型的结构可以概括为:
SYSTEM
  ROLE
  COORDINATES
  TOOLS
  OBSERVATION REUSE
  WORKFLOW
  COMPLETION
  EVALUATION MEMORY
    或 EXPLORATION MEMORY + EXPLORATION RETRY

USER
  TASK
  TASK CONSTRAINTS
  BEGIN

HANDOFF
  仅用于探索模式的后续 session
各部分承担不同职责:
| 功能类别 | Prompt 区块 | 设计目的 |
|---|---|---|
| 角色与权限 | ROLE | 限定当前任务、可用数据和操作范围 |
| 坐标契约 | COORDINATES | 统一 base 坐标、TCP、四元数顺序及相机外参的含义 |
| 工具语义 | TOOLS | 说明分割、反投影、运动和夹爪返回值分别能证明什么 |
| 观测复用 | OBSERVATION REUSE | 要求复用仍然有效的定位和几何结果,并限制重复测量 |
| 执行流程 | WORKFLOW | 将任务组织为定位、接近、抓取、抬升、放置和验证 |
| 结束判定 | COMPLETION | 区分模型判断与环境成功信号,规定何时调用 finish |
| 经验读取 | EVALUATION MEMORY | 读取索引和至多三份相关经验,坐标仍由当前观测确定 |
| 经验生成 | EXPLORATION MEMORY | 允许向当前 inbox 写草稿,要求记录证据、解释和适用限制 |
| 失败重试 | EXPLORATION RETRY / HANDOFF | 保存失败证据,在 reset 或新 session 后只改变一个策略 |
| 当前任务 | TASK / TASK CONSTRAINTS / BEGIN | 注入本次指令、成功条件、动作限制和初始观察要求 |
这种分类包含三个层次。第一层是稳定契约:坐标、工具含义和成功信号不随 seed 改变,由 System Prompt 统一维护。第二层是运行变量:User Prompt 在启动时填入任务指令、成功条件、场景和动作约束。第三层是模式权限:探索模式在共享规则之外增加草稿写入、reset 和 session 交接;评测模式沿用相同的坐标与操作流程,并以只读方式使用 memory。
Prompt 让模型在每一步回答三个问题:已经有哪些有效证据,哪个未决条件会改变下一动作,下一步应该调用什么工具。比如在抓取下降前,模型要检查 finger pad 是否与方块侧面重叠并避开桌面;方块抬升后,根据当前观测重新估计持物偏移;环境报告成功且图像没有冲突时,立即结束会话。
Memory 保存方法:规则来自经验,坐标来自实时观测
RPent 将经验生成和经验使用放在两个不同阶段。探索模式允许模型向当前运行的 inbox 写入经验草稿;草稿经过合并后成为已发布 memory。评测模式只能读取已发布内容,因此同一批测试中的经验库保持固定。
前期探索积累了四类直接影响 Colorstack 操作的知识:
- 在当前机械臂姿态下,finger pad 大部分位于 TCP 上方,抓取高度应根据工具几何计算;
- 方块可能在闭合和抬升过程中相对夹爪滑动,因此放置前要测量本次持物偏移;
- 场景同时包含彩色方块和彩色地垫,仅用颜色提示可能让 SAM3 分割到地垫,需要结合 overlay、形状和表面高度判断;
- 腕部相机中的视觉错位可能来自透视关系,修正动作前应核对可比较的 base 坐标。
每次评测开始后,模型先读取 MEMORY.md 索引,再选择三份相关经验。memory_reads.jsonl 记录了每次读取,因此 memory 的使用可以直接核验。在 10 次运行中,流程经验被读取 10 次,夹爪几何经验被读取 9 次,透视问题经验被读取 6 次,彩色地垫经验被读取 3 次。
工具日志还能看到经验如何进入决策。在 seed 511616025 中,腕部相机的颜色提示分割到了 z 约为 0 的大面积地垫,模型据此放弃该结果,改用方块上的点提示;转移到目标上方后,它也引用透视经验,没有把腕部图像里的表观错位直接换算成平移修正。在 seed 2390402793 中,模型用已记录的 pad 几何确定下降高度和闭合方向,同时重新测量当前持物相对 TCP 的偏移,而没有照搬旧运行的偏移数值。
memory 因此提供“如何定位、如何计算、何时复核”的规则;新布局中的方块位置和本次持物偏移来自实时观测。模型复用的是决策方法,而不是历史运行中的像素、XYZ 坐标或抓取偏移。
10 个随机布局的批量评测
批量评测使用 batch seed 2026 生成 10 个互不相同的布局 seed。每次运行启动独立进程,随机改变方块位置,初始 yaw 保持为零。所有运行读取同一份 memory 快照,并通过 LeRobot 保存两个 RGB 相机、机器人状态和控制参考。
| 配置项 | 设置 |
|---|---|
| Planner | RPent API planner |
| 模型 | openai-chat:deepseek-flash |
| 任务数量 | 10 |
| Batch seed | 2026 |
| 单次请求上限 | 50 轮 |
| 渲染模式 | GUI |
| Memory | 批次开始时固定,同批次保持只读 |
| 轨迹保存 | 每次运行保存一个 LeRobot episode |
批量器在启动时固定 memory 内容并记录哈希,随后逐个运行 seed。10 次任务的汇总结果如下:
| 指标 | 结果 |
|---|---|
| 环境判定成功 | 10 / 10 |
正常调用 finish 且进程退出码为 0 | 10 / 10 |
| 平均单次进程耗时 | 199 秒 |
| 单次进程耗时范围 | 163.5–270.0 秒 |
| 整批累计进程耗时 | 约 33.2 分钟 |
| 轨迹数据 | 10 个 episode,共 5,327 帧 |
10 次运行都采用相同的六次 move_to 动作骨架,并且都只闭合一次夹爪、释放一次。保存后的 Parquet 行数与各数据集元信息中的帧数一致。结果表明,在位置发生变化、朝向保持不变的 10 个布局中,RPent、DeepSeek、SAM3 与 MotrixSim 构成的闭环能够稳定完成这项堆叠任务。
成功运行暴露出的三个问题
1. Memory 被读取后,模型仍会重复推导
动作骨架在 10 次运行中完全一致,决策过程的长度却差异明显。最慢一次耗时 270.0 秒,输出 25,244 个 token;最快一次耗时 163.5 秒,输出 9,422 个 token。全批次模型请求累计耗时占 RPent 内部耗时的 43.0%。
日志中的冗余主要出现在动作之间:重复展开夹爪坐标变换,反复解释两个相机中的位置差异,或者增加不会改变下一动作的分割和反投影。memory 已经提供了相关规则,但提示词还没有稳定地把“读取经验”转化为“直接引用已经成立的结论”。
OBSERVATION REUSE 要求每轮只保留“有效证据、会改变动作的未决条件、下一动作”,每个阶段最多使用两个测量批次;新的测量结果不会改变动作时,模型应直接执行。日志显示,复杂感知和多视角判断会削弱这些规则的约束力,模型重新展开已经成立的结论。优化重点因此落在规则的优先级和执行稳定性上:让当前观测与 memory 一致时直接推进,只在证据冲突时启动一次针对性核验。
2. 成功轨迹也可能产生错误经验
前期探索曾产生一条看似合理的经验:模型发现 TCP 尚有约 2 mm 的跟踪残差,于是把残差再次加到下一次绝对运动目标上。任务最终仍落在成功容差内,模型却将这次动作总结为“有效修正策略”。
动作记录显示,move_to.xyz 本身就是绝对目标;再次叠加残差会引入偏移。该经验随后被修订为“绝对目标不能重复补偿上一动作的跟踪残差”,并用于后续评测。
另一次探索把较窄的可见表面范围解释为“被手指遮挡”,并提出用另一视角的跨度补齐中心。现有观测无法支持这条因果解释,因此该经验被删除。
这两个案例揭示了任务成功与经验正确之间的差异:环境判定验证堆叠结果,经验审核验证模型对过程的解释。可复用经验需要明确区分工具观测、原因解释、操作建议和适用条件;结构校验保证笔记格式,语义审核确认结论与证据之间的对应关系。
3. 冗长的 finish 总结触发了额外重试
7 次运行的 finish 总结超过 1,200 字符限制,共触发 9 次参数拒绝。模型在总结中重新罗列抓取坐标、夹爪几何、持物偏移和释放过程,而这些细节已经保存在工具记录和自动诊断文件中。
每次参数拒绝都会把错误返回给模型,再由模型生成更短的总结并重新调用 finish。这 9 次重试发生在物理任务已经完成之后,额外占用了模型请求和会话结束时间。
finish 的输入应收敛为三项:执行结果、环境证据和关键问题。抓取坐标、夹爪几何与动作序列继续由结构化记录保存。明确这项分工,可以让环境成功直接进入会话结束阶段,消除重复转述带来的收尾开销。
Enjoy Reading This Article?
Here are some more articles you might like to read next: